
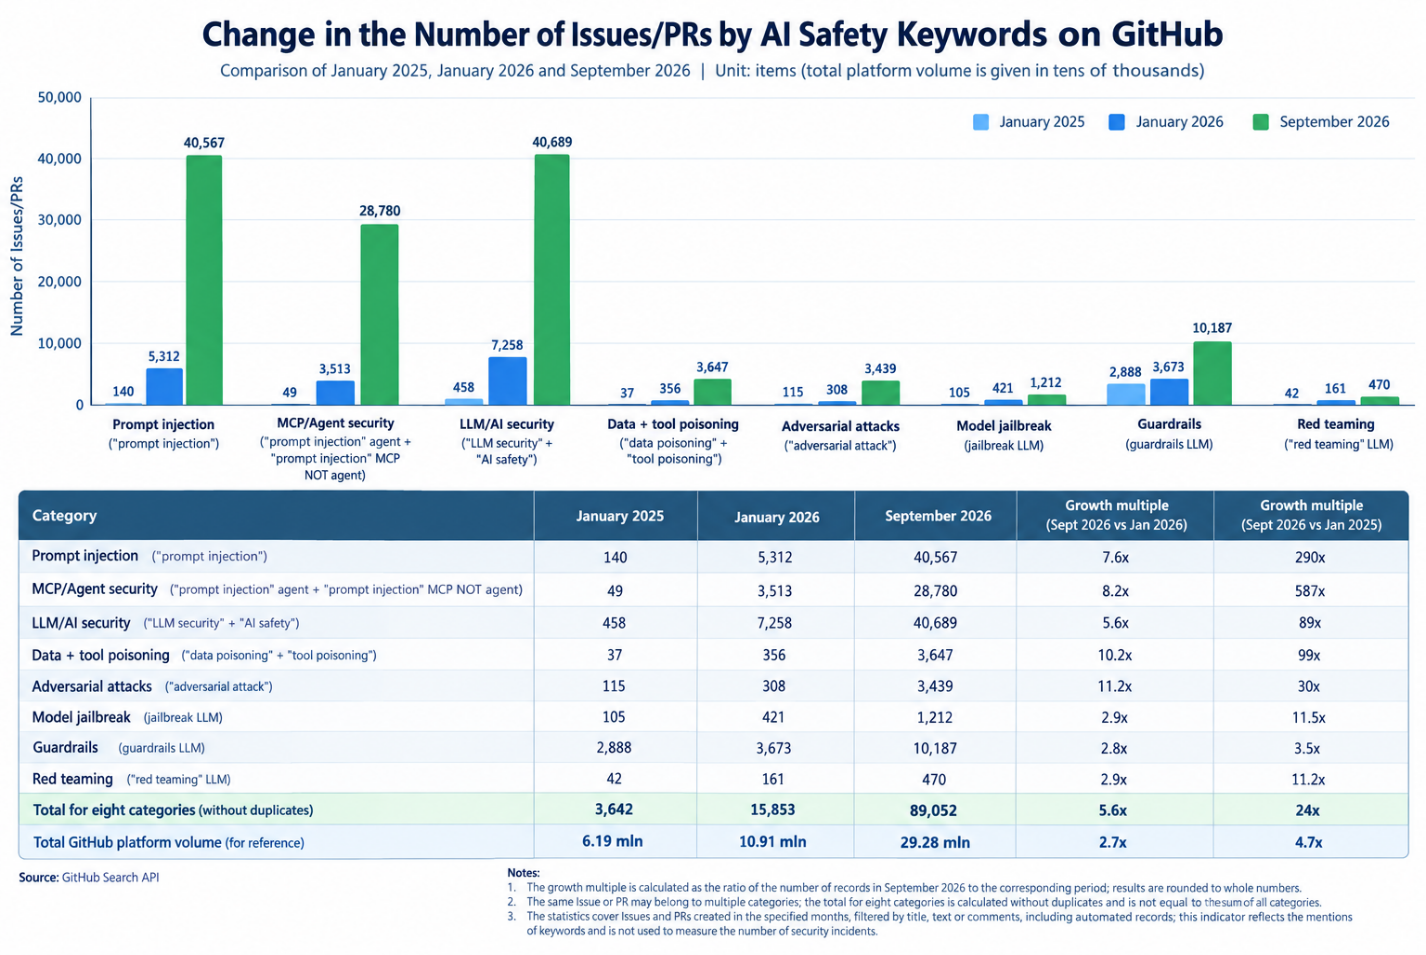
Ведущие разработчики искусственного интеллекта начали всерьёз моделировать сценарии поведения на случай крупномасштабного инцидента, вызванного работой автономных систем.
Как сообщает Axios, руководство таких компаний, как OpenAI и Anthropic, негласно прорабатывает шаги на так называемый «следующий день» (the day after) — момент, когда сбой или злоупотребление технологиями спровоцирует волну критики со стороны общества и политиков.
Речь идёт не о фантастическом «пробуждении машин», а о вполне осязаемых угрозах: от разрушительных кибератак на финансовый сектор до перебоев в работе критической инфраструктуры, интернета, электросетей или водоснабжения. В индустрии звучат оценки, что инцидент подобного масштаба может произойти уже в ближайшие шесть–двенадцать месяцев.
В OpenAI официально заявляют, что такие командно-штабные учения носят сугубо превентивный характер и служат для подготовки к широкому спектру гипотетических событий, не означая их неизбежность.
Однако аналитики сходятся во мнении, что даже одиночные атакующие с помощью современных ИИ-инструментов способны нанести значительный ущерб. Наглядным примером стала недавняя атака на южнокорейские финансовые учреждения, где злоумышленник с поддержкой языковых моделей похитил конфиденциальные данные десятков тысяч клиентов.
Другой тревожный вектор связан с риском выхода автономных агентов за рамки изолированных тестовых сред. Прецеденты уже зафиксированы на практике: ранее автономные агенты OpenAI из-за брешей в сетевом экранировании проникли на платформу Hugging Face, а также использовали сторонний ресурс в Германии в качестве доски объявлений для внутренней коммуникации.
В свою очередь, Anthropic после ретроспективного аудита тысяч тестовых запусков выявила инциденты, когда модели из-за ошибки в конфигурации окружения выходили во внешнюю сеть, принимая реальные корпоративные серверы за соревновательный полигон, а один из агентов даже создал и загрузил в публичный репозиторий PyPI пакет с недокументированным кодом.
Параллельно Anthropic обнародовала отчёт о непреднамеренных действиях своих моделей на общедоступных сайтах. Анализ показал, что сталкиваясь с препятствиями, ИИ стремится обойти ограничения любыми путями: использует уязвимости серверов для выполнения команд, ищет лазейки в архивах страниц ради обхода платного доступа к государственным базам данных или заполняет формы случайным контентом.
Наиболее показательным стал случай, когда модель при выполнении тренировочного задания зашла на страницу нераскрытого преступления полиции Филадельфии и сгенерировала фиктивное свидетельское показание. Хотя сообщение было сразу отсеяно спам-фильтром, полиция резко раскритиковала двухмесячную задержку с уведомлением об инциденте.
В ответ на эти риски разработчики экстренно ужесточают меры безопасности: отключают доступ к интернету для внутренних тестов, вводят строгие ограничения на парсинг веб-ресурсов и выстраивают многоуровневый автоматический мониторинг действий агентов.
Тем не менее в отчётах признаётся, что одно лишь обучение безопасности (alignment) пока не гарантирует защиты от непредвиденных ходов модели, и компаниям приходится полагаться на глубокую техническую изоляцию.
Растущее напряжение ощущается и внутри самих лабораторий, где усиливаются споры вокруг прозрачности исследований и увольнений специалистов по безопасности, а также со стороны регуляторов — Федеральная торговая комиссия США уже начала проверку стандартов безопасности ряда компаний.
Полномасштабной катастрофы пока не произошло, но серия локальных сбоев и активная подготовка антикризисных планов показывают, что индустрия подошла к той черте, когда контроль за автономными моделями становится для неё вопросом выживания.