
Редакция авторитетного журнала по машинному обучению TMLR провела необычный эксперимент, который вскрыл тревожную тенденцию в современной науке. Сопредседатель редакционной коллегии Нихар Шах из Университета Карнеги — Меллона в течение двух недель вместо формального отклонения десяти слабых рукописей приглашал их авторов на личные беседы, задавая простейшие вопросы о постановке задачи, значении символов и месте ключевых результатов в тексте.
Итог оказался показательным: все десять статей в конечном счете были отклонены, причем авторы трех из них не смогли ответить даже на базовые вопросы о собственном исследовании, а один участник не нашел в рукописи заявленных в аннотации выводов.
Особую пикантность ситуации придало то, что двое авторов, проваливших устную беседу, прислали после встречи письменные ответы, которые детектор искусственного интеллекта оценил как стопроцентно сгенерированные машиной.
Проблема оказалась системной, а не единичной. За год поток рукописей в TMLR вырос втрое, а доля статей с единственным автором увеличилась в тринадцать раз, при этом доля отклонений без внешнего рецензирования подскочила с шести до пятидесяти трех процентов.
В ответ журнал ввел годовые квоты на публикации, привязанные к числу соавторов, обязательное приложение к каждой рукописи рецензии от искусственного интеллекта, оценивающей лишь надежность доказательств, и новое требование ясного изложения, которому чисто машинные тексты, по мнению редакции, соответствовать не способны.
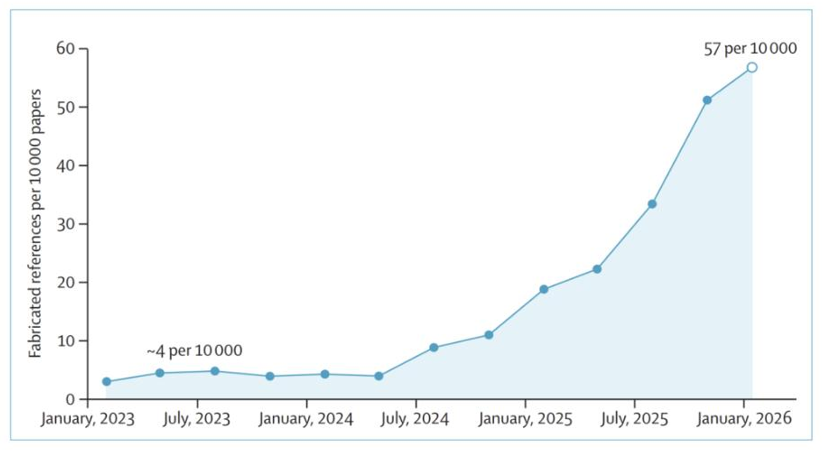
Аналогичные меры принимают и другие площадки: организаторы конференции NeurIPS обнаружили, что почти треть позиционных докладов имеет признаки полной генерации, а модераторы архива arXiv ввели годичный запрет на публикации для авторов, уличенных в непроверенных результатах работы моделей, включая вымышленные ссылки, доля которых в биомедицинских статьях выросла за три года более чем в десять раз.
В качестве более масштабной альтернативы Шах и его коллеги предложили методику greCAPTCHA, которая проверяет не текст, а самого исследователя: система автоматически генерирует вопросы по представленной работе, и автор отвечает на них в контролируемых условиях, демонстрируя способность критически оценить собственный вклад.
В тестовом режиме методика уверенно отличала авторов от посторонних, хотя и допускала около двадцати процентов ложных обвинений, а участники жаловались на строгость критериев и несправедливость к тем, кто писал статью в соавторстве.
Главный вывод эксперимента прост и одновременно тревожен: искусственный интеллект вполне может написать научную работу, но подпись под ней обязывает человека понимать каждую строчку, и если автор не способен объяснить собственную статью, рушится не только его репутация, но и сама система доверия, на которой держится научное рецензирование.