
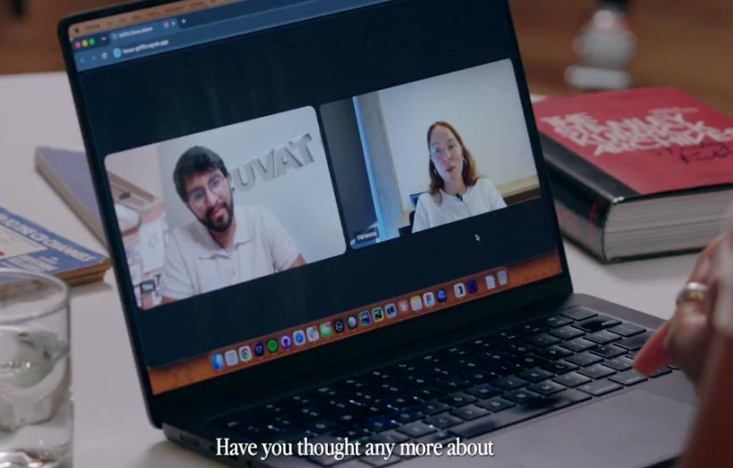
Долгое время видеозвонок оставался надежным способом подтверждения личности: если текст и голос можно подделать, то живая мимика и спонтанные реакции перед камерой внушали доверие.
Однако развитие технологий ставит под сомнение и это правило. Исследовательская команда Tavus представила модель интерактивного видео взаимодействия Griffin, заявив о прохождении первого в истории теста Тьюринга в формате видеосвязи в реальном времени.
В ходе закрытого эксперимента после минутной беседы почти половина участников приняла цифровой аватар за настоящего человека. Предыдущее поколение системы в аналогичных условиях смогло убедить лишь одного собеседника из сорока одного.
Секрет убедительности новой разработки кроется не столько в безошибочных ответах, сколько в невербальных нюансах живого общения. Традиционные ИИ-собеседники часто разрушают иллюзию человечности механическим поведением: они перебивают посреди незаконченной мысли, не реагируют на паузы для размышлений или улыбаются невпопад, когда собеседник делится грустными новостями.
Разработчики Griffin попытались преодолеть эти барьеры, создав модель, которая одновременно слушает, видит и говорит, непрерывно оценивая выражение лица, направление взгляда, интонацию и паузы партнера по диалогу.
Система способна кивать во время чужой реплики, плавно менять эмоциональную окраску, а также генерировать не просто лицо, а полноценную сцену с движениями рук, пальцев и естественными тенями.
Технически это реализовано за счет отказа от классической последовательной цепочки, где распознавание речи, работа языковой модели и анимация аватара идут строго друг за другом.
Вместо этого Griffin использует полнодуплексную архитектуру, состоящую из движка непрерывного моделирования диалога и модуля генерации аудио и видео. Система переоценивает статус разговора с интервалом менее секунды, что позволяет модели вовремя остановиться, если ее перебили, или уступить право слова.
Видеопоток формируется фрагментами с минимальной задержкой порядка сорока трех сотых секунды, обеспечивая высокое качество синхронизации губ и стабильность картинки на базе потоковой диффузии.
Высокие результаты подтверждаются и независимыми бенчмарками вроде Nvidia VideoFDB, где модель вплотную приблизилась к показателям реальных людей в задачах генерации и восприятия невербальных сигналов.
Тем не менее, эксперты призывают относиться к заявлениям о полном прорыве с осторожностью. В эксперименте участвовали всего пятьдесят четыре человека, хронометраж звонка был ограничен одной минутой, а участники изначально были настроены на разговор с человеком.
Кроме того, оценка беглости и гладкости диалога оказалась заметно ниже показателей естественности и доверия к внешнему образу, а те, кто заподозрил подвох, почувствовали искусственную природу собеседника уже в первые двадцать секунд.
Подобный скачок в реалистичности открывает широкие возможности для онлайн-образования и интерактивной поддержки, где виртуальный помощник сможет заметить замешательство ученика или визуально оценить неисправную деталь перед камерой.
В то же время технологии такого уровня несут серьезные риски злоупотреблений. По этой причине создатели ограничили доступ к предварительной версии узким кругом доверенных тестировщиков и сосредоточились на внедрении обязательной маркировки искусственного происхождения аватара.
Чем правдоподобнее синтетический человек держится на экране, тем важнее гарантировать, чтобы пользователь всегда точно знал, кто находится по ту сторону дисплея.