
Каждый, кто активно пользуется искусственным интеллектом, знаком с ситуацией, когда после нескольких уточняющих фраз в диалоге расход токенов растет непропорционально быстро.
Пользователю кажется, что он лишь попросил переставить вывод в начало или добавить страницу сравнения, однако в фоновом режиме модель каждый раз заново обрабатывает весь массив исходных материалов, инструкций и истории беседы.
Именно эту скрытую статью повторных расходов OpenAI решила устранить в ходе недавнего обновления механизма кеширования подсказок для моделей семейства GPT-6.
Принцип работы технологии прост и изящен. При чтении длинных текстов нейросеть не запоминает их дословно, а вычисляет сложные промежуточные состояния, необходимые для поддержания логической связности ответа.
Кеширование сохраняет эти уже рассчитанные промежуточные результаты, позволяя при следующем обращении не выполнять повторную работу, а сразу продолжить с готовой точки.
По сути, это аналог черновика, оставленного на парте после решения задачи: если начало условия не изменилось, можно смело продолжать вычисления, не переписывая все заново.
При этом важно понимать, что кеш — это не память и не копия прошлого ответа: модель по-прежнему генерирует новый результат, просто избавляется от дублирующего чтения старых данных.
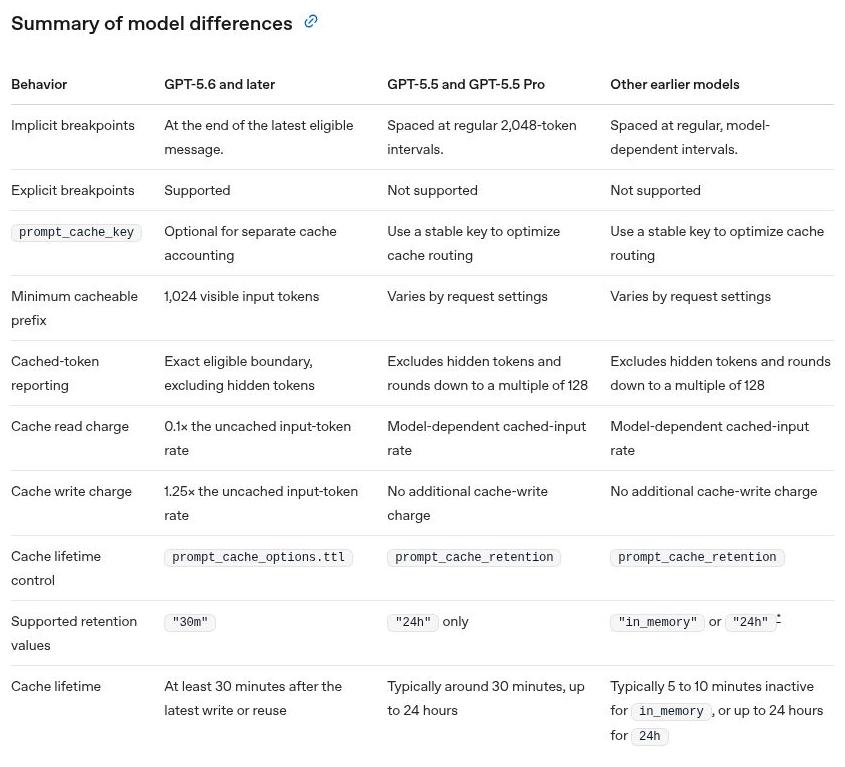
Экономический эффект впечатляет на бумаге. Первичная запись материала в кеш обходится в полтора раза дороже обычной обработки, зато последующие обращения к уже сохраненному содержимому стоят всего десятую часть стандартной цены.
Если один и тот же объем данных используется десять раз подряд, суммарные расходы на этот фрагмент сокращаются более чем на три четверти. Однако столь радикальная скидка распространяется исключительно на повторно используемые материалы: новые вопросы, генерируемые ответы и прочие вычисления тарифицируются как обычно.
Более того, если дорогостоящая запись в кеш так и не получит повторного обращения, пользователь в итоге заплатит даже больше, чем без всякой оптимизации.
Главная уязвимость механизма — жесткое требование точного совпадения. Кеш срабатывает лишь тогда, когда начало запроса полностью идентично предыдущему, вплоть до системных инструкций, описаний инструментов и вложенных файлов.
Достаточно изменить одну деталь в начале промпта, например добавить актуальную метку времени, и вся цепочка сохраненных вычислений мгновенно обесценивается. Разработчикам приходится соблюдать строгую дисциплину: неизменяемые элементы размещать в начале запроса, переменные — в конце, избегать переименования инструментов и аккуратно регулировать параметры рассуждений, не разрушая общий префикс.
Вместе с механизмом экономии OpenAI представила и инструменты контроля. Новый диагностический интерфейс наглядно показывает, какая доля входных данных была взята из кеша, а какая потребовала повторной обработки, и позволяет точно вычислить потери от каждого изменения конфигурации.
Дополнительно появилась функция предварительного прогрева, когда системные инструкции и справочные материалы обрабатываются заранее, еще до первого слова пользователя, что заметно ускоряет отклик.
Практика подтверждает эффективность подхода: крупные приложения повысили долю попаданий в кеш до девяноста процентов, а сервисы программирования сократили объем повторной обработки более чем вдвое.
Впрочем, для рядового пользователя подписных сервисов вся эта экономия пока остается невидимой, поскольку между снижением себестоимости вычислений и финальной ценой подписки стоит коммерческая политика продукта.
Сэкономленные ресурсы могут превратиться в более дешевые тарифы, расширенные лимиты или более сложные функции, но гарантированного удешевления счета не обещает никто.
Тем не менее направление движения очевидно: по мере перехода искусственного интеллекта от коротких диалогов к многочасовым автономным задачам конкуренция смещается с качества отдельных ответов на искусное управление вычислительными ресурсами, и именно те, кто научится максимально эффективно использовать уже прочитанные материалы, смогут предложить пользователям по-настоящему выгодные условия.