
Глобальная волна удешевления технологий искусственного интеллекта докатилась и до голосового сегмента, где китайский технологический гигант Alibaba предпринял решительное наступление.
На конференции Apsara 2026 компания представила обновленную линейку речевых моделей Qwen-Audio-3.1, охватывающую распознавание речи, синтез и полнодуплексное взаимодействие в реальном времени, а также архитектуры следующего поколения для глубокого анализа и комплексной генерации аудио.
Главным рыночным потрясением стало беспрецедентное снижение стоимости API: тарифы на синтез речи упали примерно на семьдесят процентов, интерактивное голосовое взаимодействие подешевело на восемьдесят пять процентов, а стоимость распознавания речи рухнула на рекордные девяносто пять процентов.
Технологическое обновление затронуло ключевые аспекты работы со звуком. Новая модель распознавания речи демонстрирует среднюю частоту ошибок на уровне четырех с половиной процентов на публичных бенчмарках, превосходя конкурирующие решения с открытым исходным кодом от ByteDance и Tencent.
Система способна понимать тридцать языков и шестнадцать китайских диалектов, обеспечивая потоковое распознавание с задержкой отклика около ста шестидесяти миллисекунд.
Она автоматически разделяет реплики разных спикеров, учитывает наложения голосов, убирает слова-паразиты и сразу выдает структурированный текст с временными метками для протоколов и встреч.
Одновременно с этим модуль синтеза речи научился бесшовно переносить тембр одного голоса на разные языки и диалекты, чутко управляя интонациями и эмоциональной окраской в зависимости от контекста.
Модель диалога в реальном времени перешла на полноценный дуплексный режим, научившись игнорировать посторонний шум, вовремя вступать в беседу или выдерживать естественную паузу, а также вызывать внешние инструменты и базы знаний прямо во время разговора.
В дополнение к этому экспериментальные модели линейки Next вышли за рамки простой расшифровки: одна из них способна анализировать окружающие звуки и механические шумы наравне с голосом, а вторая берет на себя роль звукорежиссера, объединяя речь, фоновые шумы и эффекты в единую звуковую дорожку для подкастов, игр и дубляжа.
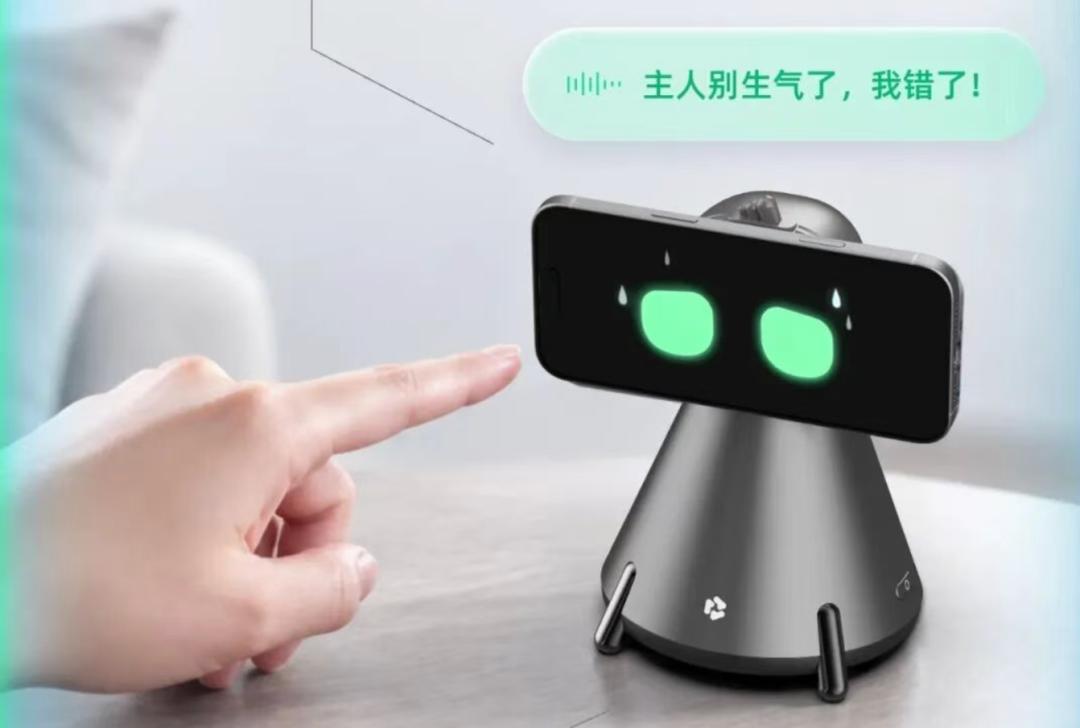
За масштабным снижением цен стоит стратегическая цель Alibaba по захвату аппаратных каналов взаимодействия с пользователем. Вместе с софтверным обновлением компания презентовала портативный ассистент с автономной мобильной связью и настольного робота для офисной работы, в которые постепенно интегрируются новые голосовые сервисы.
Рассматривая естественную речь как главный интерфейс будущего между человеком и нейросетями, разработчики делают ставку на то, что радикальное удешевление API в сочетании с собственными смарт-устройствами и очками создаст устойчивый и непрерывный приток пользовательского трафика в экосистему.