
Многие разработчики, создающие небольшие сервисы и чат-ботов с помощью ИИ, сталкиваются с парадоксом: сэкономленное на написании кода время уходит на бесконечную ручную правку промптов.
Стоит исправить одну неточность в ответах виртуального помощника, как модель начинает ошибаться в других, ранее безупречно работавших сценариях. В итоге специалист превращается в круглосуточного тестировщика, вручную перепроверяющего десятки типовых запросов.
Чтобы разорвать этот замкнутый круг, компания Anthropic выпустила официальное руководство по оптимизации, предложив переложить рутинную отладку на саму нейросеть Claude.
Основная концепция метода строится вокруг двух новых встроенных инструментов, доступных в среде Claude Code начиная с версии v2.1.259. Первый шаг — трансформация абстрактных пожеланий вроде «отвечай точнее» в четкую автоматизированную систему оценки с помощью команды создания тестов build-eval.
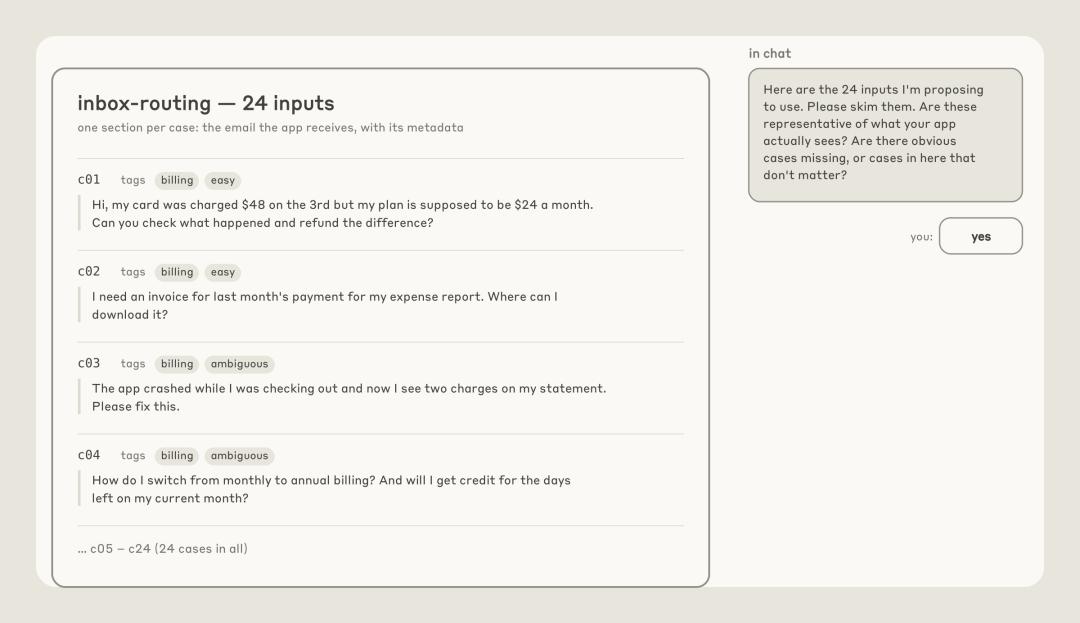
Разработчику предлагается составить репрезентативный набор реальных пользовательских ситуаций, включающий не только сложные проблемные случаи, но и базовые повседневные сценарии.
Для каждого вопроса формулируются конкретные критерии проверки: какие параметры обязательны в ответе, какие действия недопустимы и что именно считается решением проблемы.
Простые результаты проверяются программно, а для свободных формулировок привлекается сама языковая модель, работающая по утвержденному человеком чек-листу.
Когда экзаменационная база готова, запускается процесс автоматической оптимизации через команду hillclimb, реализующую алгоритм направленного поиска («восхождения на холм»).
Разработчик задает границы допустимых изменений — например, разрешение корректировать системный промпт, описания инструментов или конфигурацию модели — и формулирует цель, будь то повышение точности или снижение затрат на запросы к API.
Claude анализирует допущенные на предыдущем шаге ошибки, вносит точечное изменение и заново прогоняет тесты. Если общий показатель улучшился, правка сохраняется, а если результат ухудшился — изменение мгновенно откатывается назад.
Чтобы модель не превратилась в «натасканного отличника», заучивающего правильные ответы на конкретные вопросы, архитектура процесса использует контрольную выборку. Часть заданий держится закрытой и никогда не показывается оптимизирующему модулю.
Если после очередного изменения оценки на тренировочных тестах растут, а на контрольных падают, система диагностирует переобучение и отменяет правку. На внутреннем бенчмарке службы поддержки Anthropic такой подход позволил повысить точность решений с 78,6% до 90,5% на отложенных тикетах, одновременно снизив расходы на вызовы моделей примерно в пять раз за счет подбора более экономичных конфигураций.
Автоматизация тестирования и тюнинга не исключает человека полностью, но принципиально меняет его роль. Вместо механического перебора формулировок разработчик концентрируется на стратегических задачах: изучении реального пользовательского опыта, пополнении базы актуальными кейсами, калибровке строгости критериев и поиске разумного баланса между стоимостью генерации и глубиной ответов.
Передача рутинной регрессионной проверки искусственному интеллекту возвращает разработчикам время для развития самого продукта, избавляя от необходимости вручную перепроверять каждое исправление.