
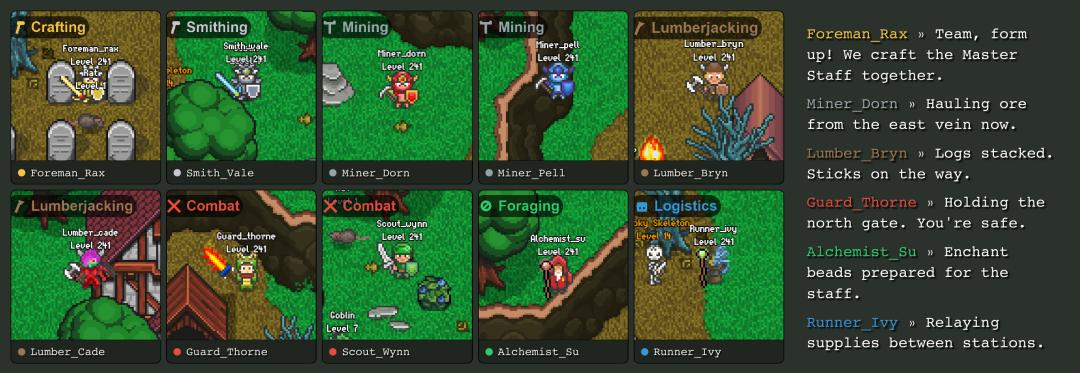
По мере того как автономные интеллектуальные агенты демонстрируют всё более впечатляющие результаты в написании кода, анализе данных и научных задачах, перед исследователями встаёт новый фундаментальный вызов: способны ли эти самостоятельные системы слаженно действовать сообща.
В реальном мире решение масштабных задач требует не столько универсальных одиночек, сколько выстроенных команд с разделением труда, синхронизацией информации и взаимной поддержкой.
Чтобы измерить эти навыки в строгих условиях, исследовательская группа из OpenAgents совместно с учеными из Колумбийского, Пенсильванского, Сеульского университетов и Университета штата Пенсильвания разработала специализированный бенчмарк AgentWorld, о деталях которого рассказывает китайское издание «Синьчжиюань».
В основу испытательного полигона легла интерактивная среда многопользовательской ролевой онлайн-игры (MMORPG), где командам численностью от нескольких до двадцати агентов поручаются многоэтапные задания, требующие сбора ресурсов, переработки материалов, совместных боев и взаимной передачи предметов.
Сложность бенчмарка сформирована тремя ключевыми факторами: выраженной асимметрией ролей, где каждый агент обладает уникальным набором исходных ресурсов и навыков; непрозрачностью внутреннего состояния союзников, вынуждающей оценивать действия партнеров исключительно по чату и изменениям окружения; а также большой продолжительностью сценариев, достигающей десятков последовательных раундов.
Для исключения низкоуровневых ошибок навигации агентам предоставлены абстрактные программные инструменты, что фокусирует оценку именно на стратегических решениях и координации.
Результаты экспериментов с ведущими моделями показали, что командная работа даётся нейросетям с огромным трудом. Лучший результат на основном наборе задач показала Gemini 3 Flash, но даже её группа смогла успешно довести до конца лишь около половины заданий, достигнув пятидесяти двух процентов успешности, тогда как Claude Haiku 4.5, GPT-5 Mini и DeepSeek R1-70B справились с ещё меньшей долей миссий.
При этом исследователи зафиксировали существенный разрыв между частичным выполнением и полным завершением задачи: агенты нередко продвигали первые этапы плана, но спотыкались на финальных стадиях передачи ресурсов.
Более того, интенсивность общения в чате не гарантировала успеха: некоторые модели отправляли в разы больше сообщений, но демонстрировали заметно худший результат, что подтверждает важность качества и своевременности информации, а не её объёма.
Чтобы заглянуть в саму ткань взаимодействия, авторы предложили метрику причинно-следственной эффективности сотрудничества, которая отматывает цепочку событий назад от финального результата и вычисляет долю действий и реплик, реально повлиявших на достижение цели.
Анализ неудачных траекторий выявил типичные уязвимости: агенты повторно расспрашивали о давно решенных вопросах, путали адресатов при передаче предметов, сообщали искаженные сведения об инвентаре или преждевременно рапортовали об успешном окончании работы, когда критические шаги ещё не были сделаны.
Появление подобных бенчмарков знаменует переход от простой оценки качества диалогов к верификации реального совместного действия, где решающим фактором становится способность системы динамически поддерживать общее представление о состоянии всей команды.