
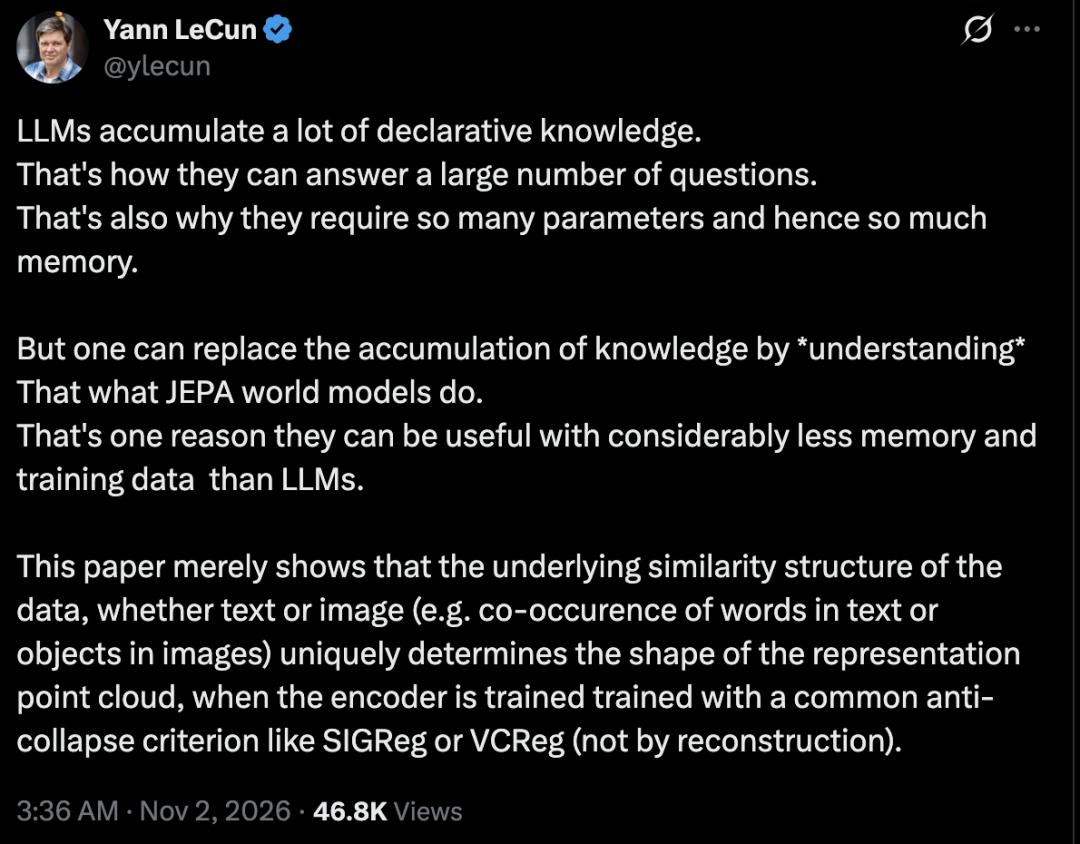
Смысл этой работы не в том, что маленькая модель «победила» большую по всем параметрам. Речь о другом: в определённой задаче качество обучения и тип представления мира могут оказаться важнее чистого размера модели. То есть масштаб сам по себе не гарантирует более глубокого понимания реальности.
LeCun и соавтор показывают, что если обучать модели на правильно подобранных «хороших видах» одного и того же мира, то их внутренние представления могут стать гораздо более согласованными между модальностями.
Иными словами, текстовая и визуальная модели могут прийти к близкой структуре понимания, даже если они учились отдельно и даже если одна из них намного меньше другой.
Но здесь важно не перепутать тезис статьи с рекламным заголовком. Это не доказательство того, что маленькая модель лучше большой во всём. Это доказательство того, что для выравнивания мировых представлений и обучения абстрактной структуры данных может быть важнее схема обучения, чем просто наращивание параметров и объёма текста.
Отсюда и главный вывод: современный упор на next-token prediction и бесконечное увеличение масштаба, возможно, не является единственным или даже лучшим путём к настоящему «понимающему» ИИ.
В более широком смысле статья снова возвращает старый спор в AI-сообществе: строим ли мы интеллект через всё большее потребление данных и вычислений, или через более правильную архитектуру обучения. ЛеКун явно ставит на второе.