
При прогнозировании действий манипуляторов и физического взаимодействия с объектами современные модели мира регулярно сталкиваются с серьезным дефектом генерации: манипулируемые предметы могут внезапно раздваиваться, бесследно исчезать или терять устойчивую форму от кадра к кадру.
В робототехнике подобная визуальная ненадежность критична, поскольку алгоритм управления рискует опираться на искаженную картину реальности. Традиционное дообучение генераторов видео опирается на глобальные метрики визуального сходства всей сцены, из-за чего локальные ошибки на небольших объектах теряются в общем объеме пикселей, а модель не получает явного требования связывать предмет в соседних кадрах в один и тот же неизменный физический объект.
Чтобы преодолеть эту системную проблему, исследователи Института передовых технологий группы China Merchants совместно с Наньянским технологическим университетом представили специализированный фреймворк EVEWorld.
В своей работе авторы ввели формальное понятие «лени модели» для описания необоснованного дублирования или растворения объектов в процессе генерации видео, а также предложили метрику для строгого учета доли таких устойчивых аномалий с поправкой на естественные перекрытия манипулятором.
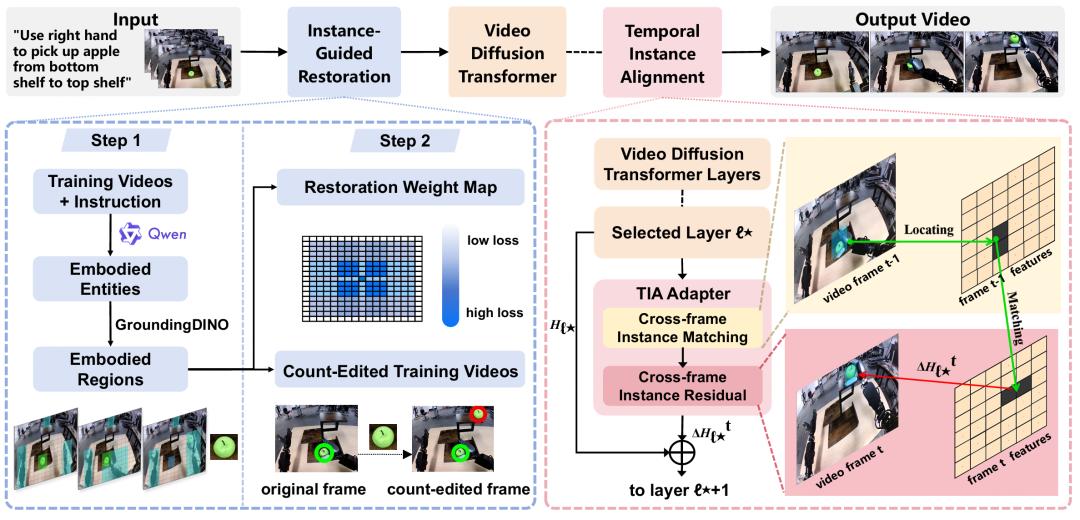
Архитектура решения состоит из двух взаимодополняющих механизмов: модуля восстановления под контролем экземпляров и блока темпорального выравнивания.
Первый модуль целенаправленно учит нейросеть исправлять ошибки подсчета предметов. В процессе подготовки обучающих данных инженеры искусственно добавляют лишний объект в кадр демонстрационного видео, после чего заставляют систему восстанавливать исходную правильную сцену с троекратным приоритетом внимания к зоне аномалии.
Второй компонент встраивается непосредственно в скрытые слои дифfusion-трансформера и принудительно отслеживает соответствие признаков между соседними кадрами, предотвращая искажение формы или внезапные телепортации предмета при переходе от одного временного шага к другому.
Экспериментальная проверка на тестах DreamGenBench показала, что внедрение предложенного подхода снизило частоту устойчивых аномалий с объектами на 85,7% по сравнению со стандартным дообучением, параллельно улучшив точность следования инструкциям более чем на тринадцать процентов.
Метод подтвердил устойчивость при переносе на незнакомые конфигурации окружения, новые платформы манипуляторов и различные базовые архитектуры, включая модели на основе оптического потока.
Разработчики отмечают, что явный контроль за эволюцией физических объектов во времени становится фундаментальным условием для превращения генеративных моделей в надежные инструменты прогнозирования для автономных роботов.