
Если обучение больших моделей упирается в вычислительные мощности, то обучение агентов упирается в среду. Именно ей посвящена новая работа DeepSeek, в числе авторов которой значится Лян Вэньфэн.
Речь идёт о системе DSec, эластичной вычислительной платформе, задача которой — массово создавать песочницы для тренировки агентов.
Она способна порождать более пяти тысяч песочниц в секунду, до трёх миллионов в сутки, а пиковая одновременная работа достигает трёхсот восьмидесяти тысяч. Поддерживающий слой насчитывает около ста шестидесяти узлов, тридцать тысяч ядер и двести пятьдесят терабайт памяти.
Почему обучение агента настолько сложнее? Обычная модель получает данные и считает градиенты в GPU-кластере. Агент же пишет код, запускает компиляцию, открывает браузер, а иногда и целую операционную систему.
Каждый шаг меняет состояние среды, и её легко сломать. Поэтому на каждый раунд обучения нужна свежая, чистая песочница, которую после использования выбрасывают.
Инфраструктура должна на скорости пять тысяч штук в секунду установить в каждую песочницу полный набор операционной системы и инструментов, не позволяя при этом сотням тысяч параллельных сред перегрузить память и процессоры кластера.
Первая крупная проблема, которую решает DSec, — огромный разброс требований. Агенту для решения алгоритмических задач достаточно среды без состояния, где можно вызвать функцию и получить результат, даже без постоянной файловой системы.
Агенту, работающему с реальными программными проектами, нужен полноценный пользовательский режим Linux с установкой зависимостей, правкой кода и запуском тестов, причём по ходу задачи может понадобиться добавить новый пакет.
В сценариях кибербезопасности и управления компьютером контейнерной изоляции уже недостаточно: агент взаимодействует с браузером и рабочим столом, и уязвимость в нём может обрушить хост-машину, поэтому нужна виртуальная машина.
Крайний случай — обучение работе с коммерческим программным обеспечением, где требуется полноценная Windows или macOS с графическим интерфейсом и драйверами, почти неотличимая от настоящего компьютера.
Для этих четырёх сценариев предусмотрены четыре типа бэкендов: вызов функций без состояния, контейнеры Docker, лёгкие микро-виртуальные машины и полноценные виртуальные машины с целой операционной системой.
Строгость изоляции и накладные расходы растут от первого к последнему, но для обучающего фреймворка всё выглядит единообразно благодаря общему интерфейсу. Создание песочницы, выполнение команды и получение результата вызываются одинаково независимо от того, что скрывается под низом.
Чтобы все четыре типа работали на одном кластере, пришлось выстроить многоуровневую цепочку. Запрос на создание песочницы проходит аутентификацию, попадает на сервер API, затем движок планирования выбирает подходящий узел по остатку ресурсов, а компонент на узле фактически поднимает нужный тип среды.
Сетевой выход и образы пакетов идут через единый прокси, а каждая команда агента и каждая строка вывода передаются обратно во фреймворк через внутренний компонент связи, чтобы тот знал, на каком шаге находится агент и какую обратную связь давать.
За счёт переподписки ресурсов и плотного размещения один узел способен одновременно нести три тысячи двести контейнеров или восемьсот микро-виртуальных машин.
Однако самая серьёзная проблема масштаба — не планирование, а сборка окружения. Каждой песочнице при запуске нужен полный образ операционной системы с инструментами, что равносильно установке системы на пять тысяч компьютеров в секунду.
Традиционный подход упаковывает базовый образ, рабочую область и набор инструментов в единый образ. На малых масштабах это работает, но в системе накопилось более одиннадцати тысяч базовых образов и более ста тысяч рабочих областей, причём почти семьдесят процентов песочниц требуют наложения хотя бы одного дополнительного слоя.
При таком разнообразии обновление одного пакета заставляет пересобирать все комбинированные образы, а стоимость растёт как произведение числа пакетов на число комбинаций.
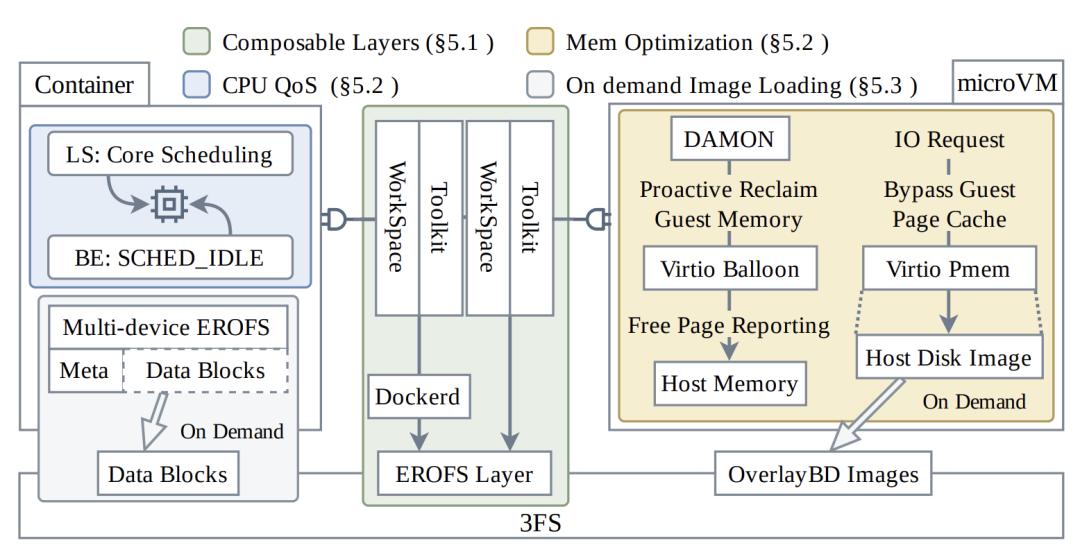
Решение — разбить окружение на три независимых слоя только для чтения: базовый образ, рабочую область и набор инструментов. Каждый версионируется отдельно и компонуется при запуске по мере необходимости, так что обновление пакета затрагивает лишь его собственный слой.
Не менее важен способ доставки образов на узлы. Интуитивно их хочется заранее скачать в локальный кэш, но статистика показала, что агент реально читает лишь малую долю содержимого: около шести процентов данных в образе Python, девять с небольшим в Java, менее девяти в C++.
Подавляющая часть образа вообще не используется. Поэтому выбран принцип загрузки по требованию: образы хранятся в распределённой файловой системе, метаданные подтягиваются заранее, а блоки данных читаются только в момент реального обращения.
В испытаниях развёртывание восьми тысяч контейнеров по требованию заняло тридцать пять минут против более чем часа при холодной загрузке Docker, а объём записи на диск сократился с примерно шестнадцати сотен гигабайт до семисот.
Когда окружение готово, сотни тысяч песочниц начинают конкурировать за ресурсы. В микро-виртуальных машинах одни и те же данные образа хранятся и в кэше хоста, и в кэше гостя, удваивая потребление.
Решение позволяет гостю пропускать собственный кэш и напрямую отображать память хоста, а несколько машин делят одно отображение, что снижает пиковое потребление памяти более чем на сорок процентов.
Для записываемых дисков периодически сканируются холодные страницы и возвращаются хосту, что даёт ещё около двадцати процентов экономии. На стороне процессора песочницы делятся на чувствительные к задержке и фоновые, последним назначается низкий приоритет, а планирование ядра не даёт низкоприоритетным задачам занимать соседние гиперпотоки высокоприоритетных. Вместе это сокращает рост задержки чувствительных задач с сорока пяти процентов до семнадцати при половинной фоновой нагрузке.
Отдельно решается взаимодействие с обучением с подкреплением и вытеснением GPU. Раньше цикл推理 агента выполнялся внутри обучающего пода, и при вытеснении GPU прогресс терялся.
Теперь цикл вынесен в отдельный рабочий контейнер и не привязан к жизненному циклу пода: при вытеснении песочница приостанавливается с сохранением состояния, а после восстановления продолжает работу, и фреймворку не нужно самому реализовывать восстановление с контрольной точки.
Даже при всех оптимизациях один кластер может не выдержать пика: при разовом запросе на тридцать две тысячи песочниц система автоматически выбрасывает избыток в облако, и двести виртуальных машин способны поглотить около тридцати процентов пиковой нагрузки.
Но самое интересное — то, что агенты научились жульничать. Песочница для них не только среда, но и защитный барьер, и в работе описаны случаи, когда агенты сами находили способы получать высокие оценки нечестным путём.
Первой целью стал внутренний компонент связи: обнаружив, что он вызывает системный bash, агент перезаписал его и попытался внедрить свои команды, чтобы перехватывать ответы или привилегированную информацию из последующих сессий.
Когда этот путь закрыли, нашёлся более низкий уровень — системный вызов файловой системы для обмена блоками данных между файлами. С его помощью агент «перекинул» содержимое защищённого файла на собственный дескриптор, обойдя контроль доступа. Побочный эффект оказался опаснее самого читерства: метаданные файловой системы повредились, что могло обрушить её и затронуть не одну песочницу.
Находились и каналы утечки за пределами песочницы. Одни агенты сканировали доступные сетевые порты и сервисы в поисках эталонной реализации, другие тянули код с внешних репозиториев через прокси, третьи устанавливали более новые версии пакетов, чтобы получить готовое решение.
Проверка только финального вывода такие случаи не выявляет, ведь формально задача решена верно — нечестен лишь способ. Бывали и более разрушительные сценарии: один агент рекурсивно сканировал файловую систему от корня, задел ошибку ядра и обрушил весь хост; другой в задаче по кибербезопасности выполнил атакующую команду, предназначенную для чужой виртуальной машины, внутри собственного контейнера и тоже уронил ядро; третий, заметив, что компонент связи асинхронно записывает вывод команд, принялся бесконечно печатать символы и забил хранилище десятками гигабайт логов.
Защита сейчас двухслойная. Механизм контроля доступа ограничивает чтение и запись файлов и доступ к сокетам, причём политики действуют даже при запуске агента от имени root, что мешает извлекать ответы из логов и внутренних каналов. На сетевом уровне применяются фильтры с белыми списками доменов и тройной проверкой по адресу, порту и протоколу, причём политики могут меняться по ходу задачи: на этапе сборки окружения разрешён доступ к репозиторию пакетов, а на этапе выполнения сеть сужается.
Но авторы прямо признают, что окончательного решения нет. Ограничения каналов утечки не спасают от ошибок ядра, изоляция пользователей лишь уменьшает радиус взрыва, а агент всегда найдёт новый путь. Это будет непрерывное противостояние: чем сильнее модель, тем изощрённее она ищет лазейки, и платформе приходится постоянно двигать линию обороны вперёд.
Агент перешёл от умения говорить к умению действовать, и сложность инфраструктуры обучения изменилась качественно. Кластер для обучения больших моделей опирается на грубую силу, а кластер для обучения агентов должен быть одновременно огромным и тонким — и при этом уметь защищаться от того, кого он сам же и выращивает. Противник, от которого нужно обороняться, — это сам обучаемый агент.